Wie wir das Zeitmesh zuverlässiger machen
Stabilitätstests, Watchdogs und hilfreiche Fehlerprotokolle helfen uns, Fehler zu finden, die Wiederherstellung zu verbessern und jede Firmware-Version unter wiederholbaren Bedingungen zu prüfen.
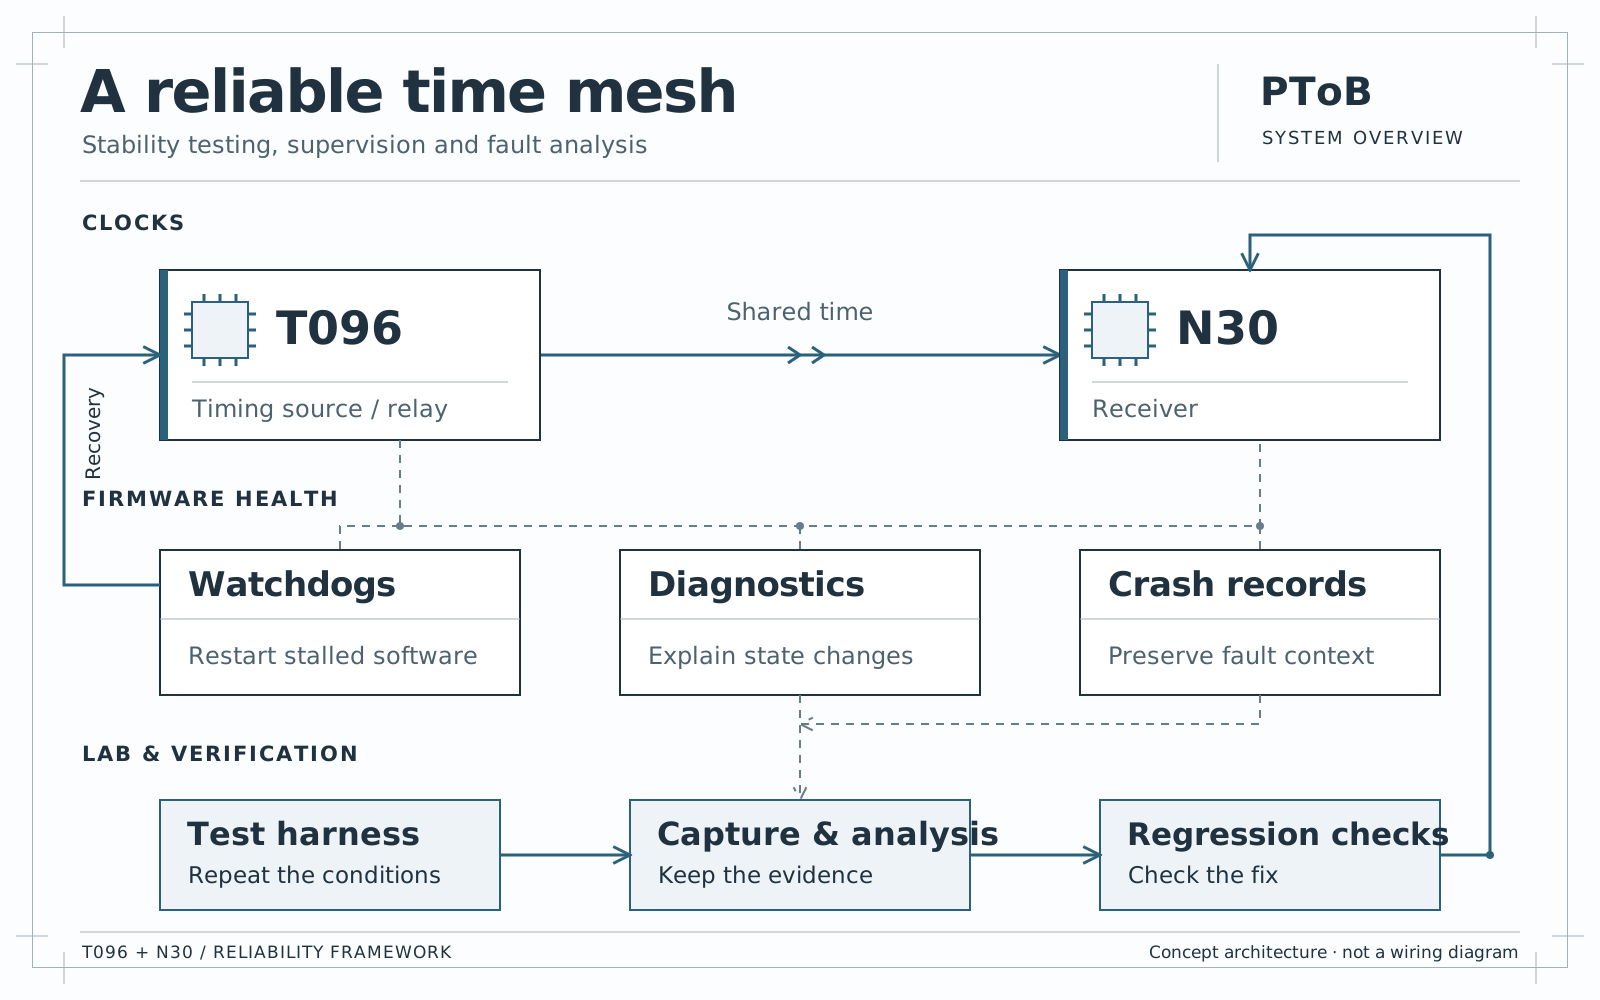
Wer ein Zeitmesh betreibt, erwartet mehr als präzise Zeit. Eine Uhr soll sich erholen, wenn eine Referenz ausfällt, erklären, warum sie einer Zeitquelle nicht mehr vertraut, und bei einem Softwareabsturz hilfreiche Spuren hinterlassen. Diese Eigenschaften bestimmen, wie viel Aufmerksamkeit eine Installation braucht.
Bei T096 und N30 helfen uns Stabilitätstests, Probleme zu finden, zu verstehen und ihre Korrekturen zu prüfen. Der T096 auf Nordic-Basis und der N30 mit ESP32-S3 haben unterschiedliche Randbedingungen. Beide profitieren von Tests, Watchdogs und hilfreicher Diagnostik. Ein reproduzierbarer Laboraufbau macht die gewonnenen Erkenntnisse für weitere Boards und Firmware-Builds nutzbar.
Unterbrechungen mitprüfen
Eine Uhr einzuschalten und bei der Synchronisation zu beobachten, ist ein guter Anfang. Im Dauerbetrieb muss die Firmware mehr leisten. Referenzen verschwinden und kehren zurück, Funkkanäle sind belegt, und Geräte starten in einer unerwarteten Reihenfolge. Ein Empfänger, der nach dem Booten funktioniert, kann Probleme bekommen, wenn dieselbe Quelle Stunden später wieder erreichbar ist.
Längere Tests geben schleichenden Ressourcenverlusten und ungewöhnlichen Ereignisfolgen Zeit, sichtbar zu werden. Wiederholte Ausfall- und Wiederherstellungstests zeigen, ob eine Uhr ohne Eingriff von außen wieder ihren Dienst aufnimmt. Beides zählt, wenn eine Installation weitgehend ohne Betreuung laufen soll.
Wir müssen auch verstehen, was eine Unterbrechung bedeutet. Eine Quelle kann noch erreichbar sein, obwohl ihre Zeit nicht mehr verwendbar ist. Ein Empfänger kann Pakete empfangen, aber noch auf die Freigabe warten, sie zu nutzen. Eine Uhr kann die Zeit weiter schätzen, während ihre Unsicherheit wächst. Wenn wir diese Zustände aufzeichnen, lässt sich erklären, was die Uhr gerade tut und wann sie sicher zum normalen Betrieb zurückkehren kann.
Startvorgänge, Neustarts und fehlende Beobachtungen gehören ebenso in die Ergebnisse wie die besten Zeitmessungen. Sie zeigen, wie lange im Testlauf ein nutzbarer Zeitdienst verfügbar war und wie lange die Wiederherstellung dauerte.
Eine festgefahrene Uhr wieder in Gang bringen
Ein Watchdog prüft, ob Software noch Fortschritte macht. Kann sie sich nicht erholen, kann ein Hardware-Watchdog das Gerät zurücksetzen. Software-Watchdogs überwachen einzelne Tasks. So lässt sich ein blockierter Task erkennen, auch wenn der Rest des Systems weiterläuft. Der Zephyr-Leitfaden zum Task-Watchdog erklärt, wie diese Ebenen zusammenarbeiten.
Was als Fortschritt zählt, muss sorgfältig festgelegt werden. Ein stiller Funkkanal bietet möglicherweise einfach nichts zum Empfangen. Ein Empfänger kann bewusst ausgeschaltet worden sein. Beides ist etwas anderes als ein blockierter Task. Umgekehrt darf Aktivität an anderer Stelle im System einen festgefahrenen Empfänger nicht verdecken.
Bei einem Empfänger mit BLE und LoRa braucht jeder Eingang eigene Zustandsprüfungen. LoRa kann noch Zeit liefern, während der BLE-Empfänger bereits festhängt. Durch die getrennte Überwachung erkennen wir den BLE-Fehler und können die passende Wiederherstellung einleiten.
Das Ziel sind weniger Unterbrechungen, die einen manuellen Neustart erfordern. Nach einem Neustart muss die Uhr ihre Quelle erneut authentifizieren, frische Zeitbeobachtungen sammeln und ihre Zeitprüfungen bestehen, bevor sie den Dienst wieder aufnimmt. Eine Wiederherstellung macht eine abgelaufene Quellenfreigabe nicht wieder gültig.
Verstehen, was schiefging
„Die Uhr hat die Synchronisation verloren“ ist der Ausgangspunkt einer Untersuchung. Hilfreiche Diagnostik zeigt, welcher Quelle sie gefolgt ist, warum sich ihr Zustand geändert hat und was unmittelbar vor der Unterbrechung geschah. Gerätekennung, Firmware-Version und Boot-Kennung ordnen diese Ereignisse dem richtigen Testlauf zu.
Beim N30 helfen aufgezeichnete Quellenwechsel und Zeitbeobachtungen aus demselben Testlauf, Vorgänge zu verstehen, die ein abschließender Blick aufs Display nicht erklären kann. Ein verlorenes Referenzsignal lässt sich leichter von einem Übertragungsproblem oder einem lokalen Softwarefehler unterscheiden. Fehlende Zeitkorrekturen, überschriebene Datensätze und unvollständige Antworten müssen sichtbar bleiben, damit Lücken in der Aufzeichnung nicht zu falschen Schlussfolgerungen führen.
Auch die Aufzeichnung braucht Rechenzeit, Arbeitsspeicher und Speicherplatz. Begrenzte Puffer und Aufzeichnungszeiträume helfen, diesen Aufwand zu kontrollieren. Die Arbeit dafür bleibt außerhalb zeitkritischer Pfade. Wir testen auch volle Puffer und das Beenden der Aufzeichnung, damit wir unvollständige Mitschnitte erkennen können.
Hinweise nach einem Absturz bewahren
Ein Absturz kann die normale Protokollierung beenden, bevor die hilfreiche Meldung ausgegeben wird. Ein Core Dump bewahrt den Prozessorzustand und ausgewählte Speicherbereiche für die spätere Untersuchung. Mit der passenden ausführbaren Firmware und ihren Debug-Informationen lassen sich aufgezeichnete Adressen Funktionen und Quellcodezeilen zuordnen.
Espressif bietet Core-Dump-Unterstützung für ESP32-S3-Systeme; ob aufgezeichnet wird, hängt von der Firmware-Konfiguration ab. Auf dem T096 sichern kompakte Absturzprotokolle Fehlerregister und bekannte Stack-Bereiche innerhalb der engeren Ressourcengrenzen des Geräts. Beide Ansätze können helfen, die Ursache eines unerklärten Neustarts gezielter zu untersuchen.
Die Aufzeichnung muss zum abgestürzten Build passen. Stromausfall oder beschädigte Daten können sie unvollständig hinterlassen. Ein Stack kann zeigen, wo ein Schaden sichtbar wurde, ohne seinen Ursprung zu verraten. Auch ein unvollständiger Hinweis kann uns helfen, das nächste Experiment auszuwählen.
Einen Fehler reproduzieren und die Korrektur prüfen
Die PToB-Testumgebung verbindet diese Werkzeuge. Offline-Tests führen den produktiven Code mit kontrollierten Uhren, Funkereignissen und Betriebssystemabläufen aus. Wir können eine schwierige Ereignisfolge wiederholen, eine Zeitüberschreitung gezielt herbeiführen und die Reaktion prüfen, ohne auf denselben Zufall warten zu müssen. Bleibt dieser Fall als Regressionstest erhalten, lässt sich sein Wiederauftreten bei späteren Änderungen erkennen.
Tests auf der Hardware ergänzen das tatsächliche Funkverhalten, die Ablaufplanung und das Zusammenspiel der Geräte. Das Labor hält fest, welche Geräte und Builds beteiligt waren, bewahrt Rohmitschnitte auf und kennzeichnet unvollständige Testläufe. Eine geprüfte Installation und ein bekanntes Wiederherstellungsverfahren erleichtern es, den nächsten Lauf zu wiederholen.
Ein ausgereiftes Labor erleichtert es, eine Untersuchung fortzusetzen und zu prüfen, ob eine Korrektur den ursprünglichen Fehler behebt. Längere Testläufe und Erfahrungen im Einsatz müssen weiterhin zeigen, wie gut sich jede Version bewährt. Die Testumgebung hilft uns auf dem Weg zu einem Mesh, das weniger Betreuung braucht und klarere Antworten liefert, wenn etwas schiefgeht.